今回の記事では、ずばり、ディープラーニングモデルをLabVIEWで実装していきます。
この記事を書いている2026年11月現在、世の中には様々なAIモデルが出ているのは言わずもがななんですが、そのようなAIモデルのおおもと、いわゆるLLMの基礎にもなっているのが今回のディープラーニングモデルです。
これを、LabVIEWだけで作ってみた、というのが今回の記事の趣旨です。
なお、この記事では作成したプログラムを試した結果と、そのブロックダイアグラムの一部を紹介していますが、そのプログラムの全容を公開しているわけではありません。
あくまで「LabVIEWでこんなこともできるんだ」という、興味を持ってもらうための試みとしてやってみました。
目指したもの
今回LabVIEWで作ろうと思ったのは、いわゆる手書き数字の認識ができるモデルです。
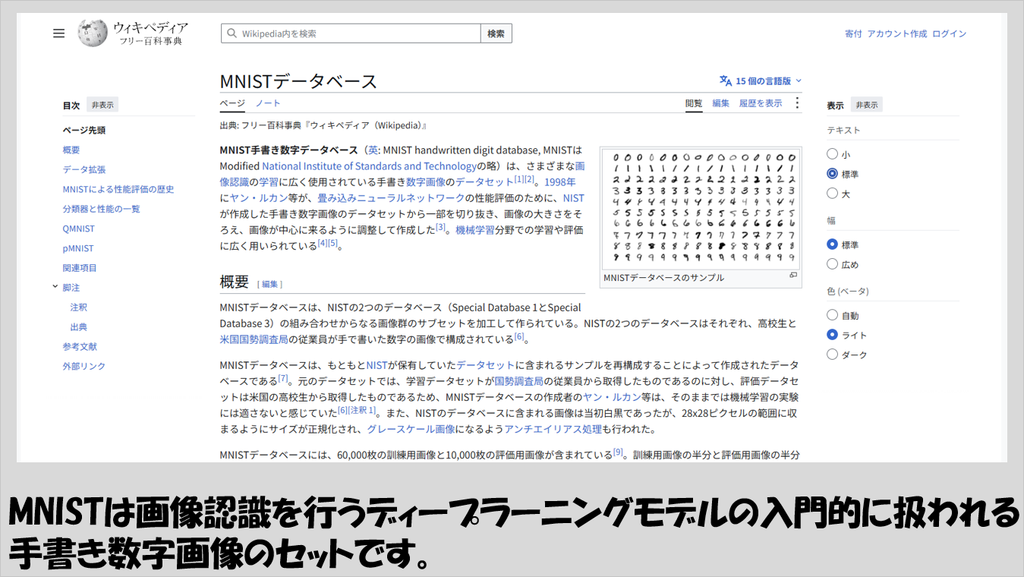
これには、MNISTというモデルが有名で、例えばPythonなんかでも簡単にそのモデルを取り入れることができます。
LabVIEWで扱う場合には、Pythonノードを使用すれば実装は比較的簡単にできますが、それでは芸がないので、Pythonノードは使用せず、他のプログラミング言語の処理をdllとして取り入れることもせず、全てLabVIEWのみでモデルの学習から推論までを行えるようにしました。
何のために?
今これだけAIが普及している中で、今さらそんなものを実装することの意味はあるのか?と思われる方も多いかと思います。
確かに、LabVIEWのみで手書き文字を認識させることそのものはほとんど意味がありません。
意味があるとしたら、Pythonなどの「LabVIEW外の環境」の用意を必要とせずに、手書き数字が識別できるようにしたい、という特定のニーズがあるときくらいでしょうか。
実は今回のアプリケーションはNigelにプログラム全体の作り方の指南をしてもらっています。
手書き数字を認識できるようになるまでのプログラムを作る、となると、そこそこの規模のプログラムになることは何となくわかるかと思いますが、そんな「そこそこの規模」のプログラム全体の作り方をNigelがどれだけちゃんと教えてくれるか、のテストとしてもともと始めました。
自分自身も、例えばOREILLY社の書籍などで、ディープラーニングモデル構築のための基礎的な部分の話は何となく知っていたので、「このviが必要」とNigelに指摘されたものをみて、確かにこういう処理が必要だな、ということを理解しつつ、ひとつひとつのviを組んでいった、という形になります。
なお、LabVIEW 2026Q3でできるようになった、Nigelによるコード生成は今回は使用していません。
おそらくコード生成をさせれば似たようなものはできると思いますが、Nigelに指示を出されながら作ることで、ひとつひとつの処理の意味を確認しながら作るという作業も大事だからです(作られたものを使っていく、というのは味気ないですし)。
世の中を便利にしているAIの技術、それが実際はこんな処理を元にしているんだ、ということが曲がりなりにもわかってくると、改めてAIのすごさや不思議さを感じることができると思います。
他の言語で実装する場合に、便利なツールキットなどを使えばできることを、あえてそのようなツールキットなどは使用しないで、LabVIEWの標準関数(LabVIEWを単体インストールしただけで使用できる関数)のみで作るという過程に面白みを感じないとやってみようという気にはならないと思いますが、参考までに見ていってもらえればと思います。
できたプログラムの例
前置きが長くなりましたが、作成できたプログラムの例を紹介します。
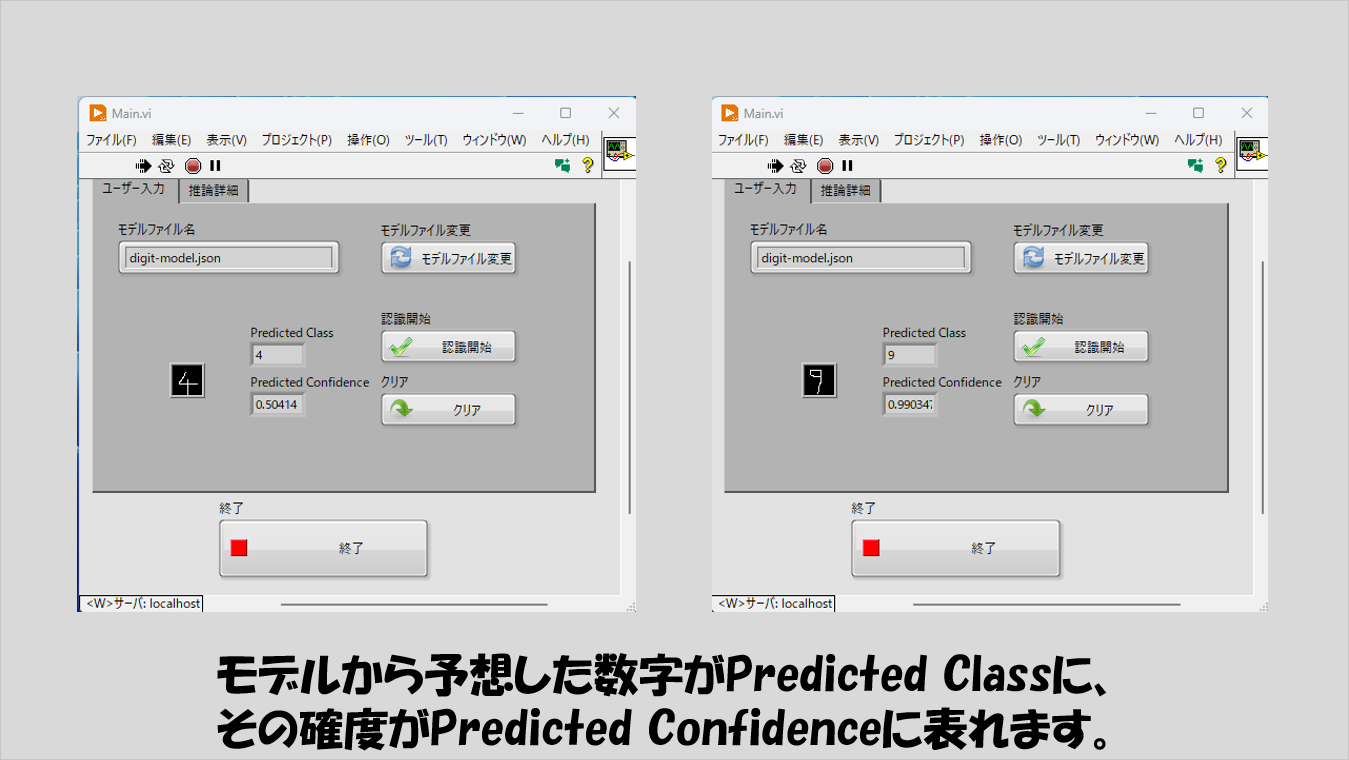
フロントパネルには、モデルファイルを指定するパス制御器と、数字を手書きする場所(ピクチャ制御器)があり、認識ボタンを押すことで、書いた数字が何なのかをLabVIEWが判定してくれます。
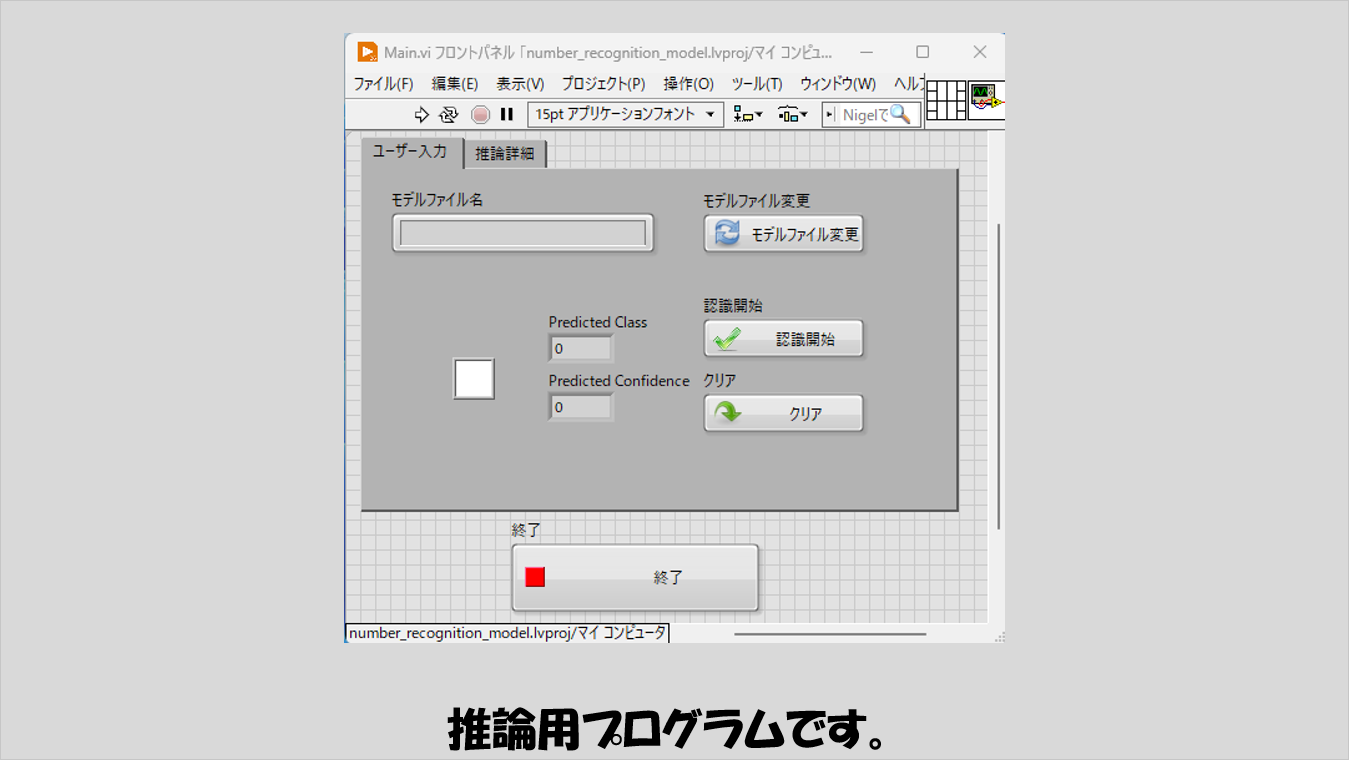
プログラムを実行すると、ピクチャ部分が黒くなり、ここにマウスで数字が書けるようになります。
ここに数字を書いて、認識開始ボタンを押すことで、書かれた数字が何かをプログラムが当てます。
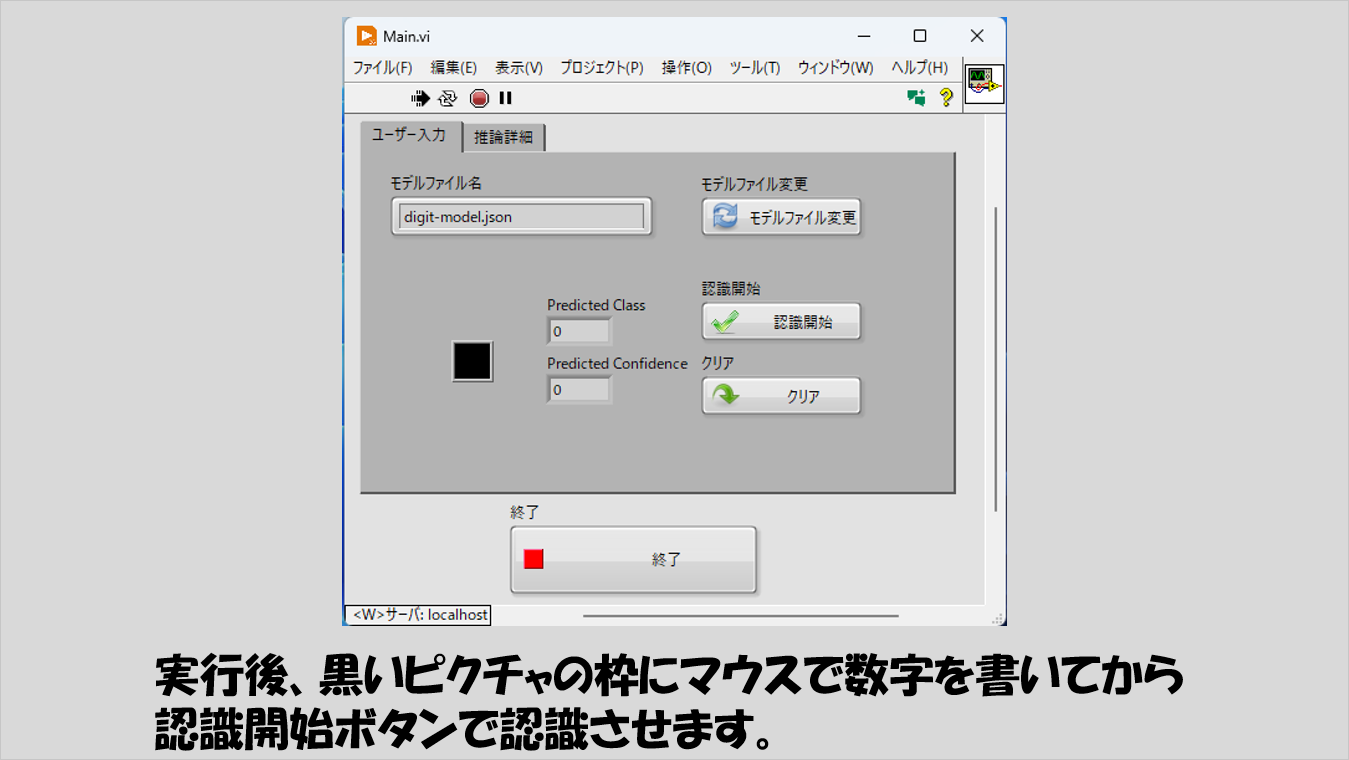
いかんせん手書き文字用の枠が小さい(これはディープラーニングモデルでの入力層のベクトルのサイズを小さくするためです。畳み込みなど行うことでより元のベクトルのサイズが大きくても小さくしてからモデルに入れることもできますが、今回はそこまでは実装しませんでした)ことと、手書き文字そのものは黒い画像に白い線で数字を書くだけとしているので「文字の濃淡」といった概念がないことから、判定精度は高いとは言えませんでした。
とはいえ、でたらめにLabVIEWが推論している、という感じというよりは正解するため、「改善の余地はあるが基本的な部分はできている」という出来になりました。
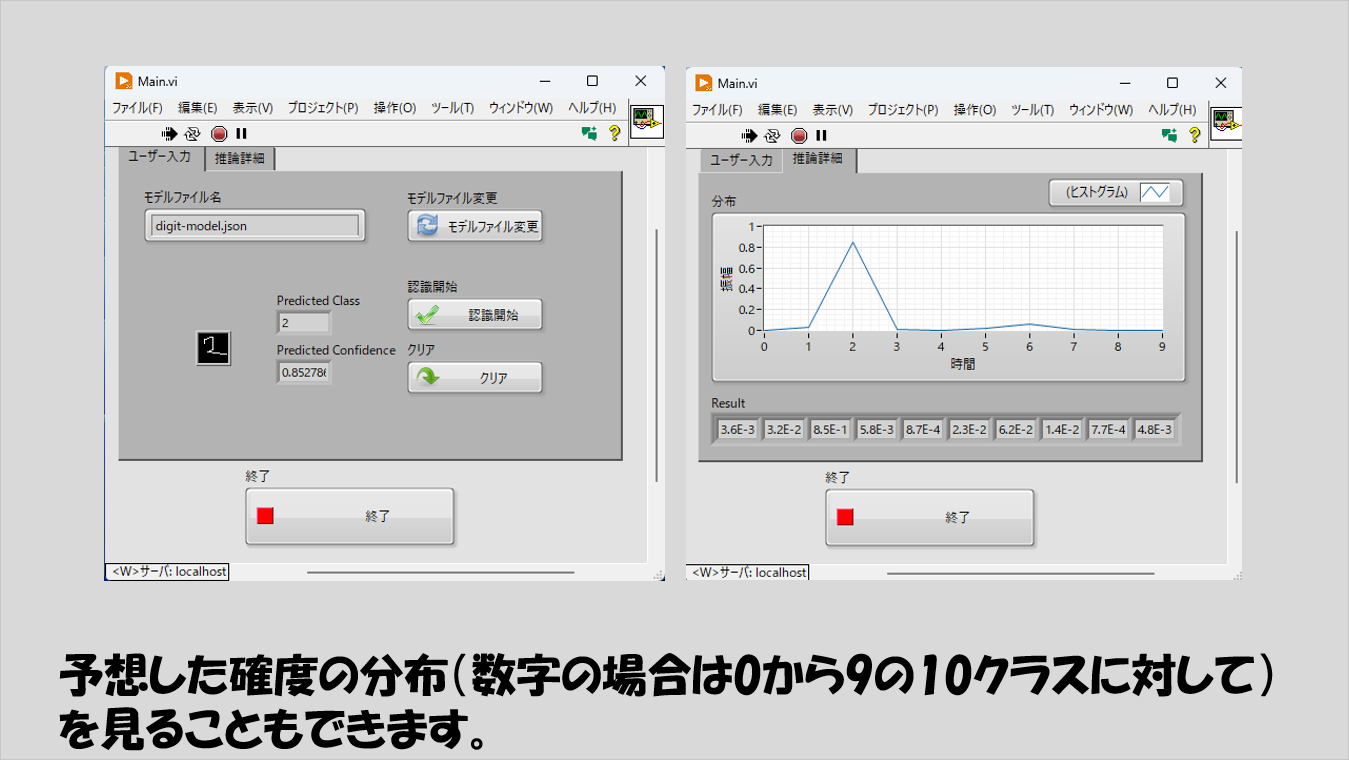
なお、手書き数字は0から9までの10通りなので、10クラスの分類、ということになります。
書かれた数字に対して、各クラスである確率の高さを表示するという機能も付けています。
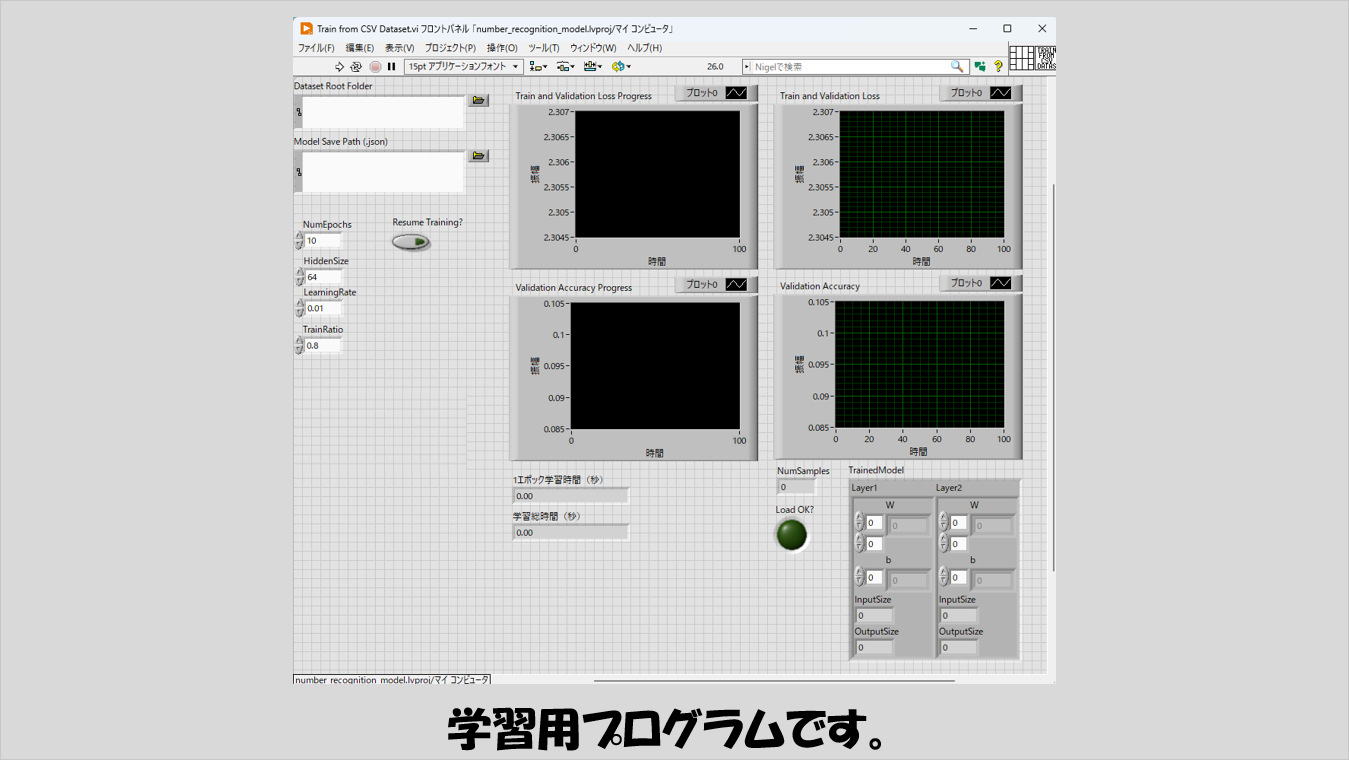
これはあくまでモデルをある程度トレーニングさせた後の状態ですが、もちろんモデルをトレーニング、学習させるためのプログラムもあります。
学習時には、用意した手書き数字のデータ(今回は各数字に対して100個の画像を用意)からモデルを訓練させました。
いわゆる損失の推移も見れるようにしています。(下の図の、右上のグラフの白い線が損失の変化です)
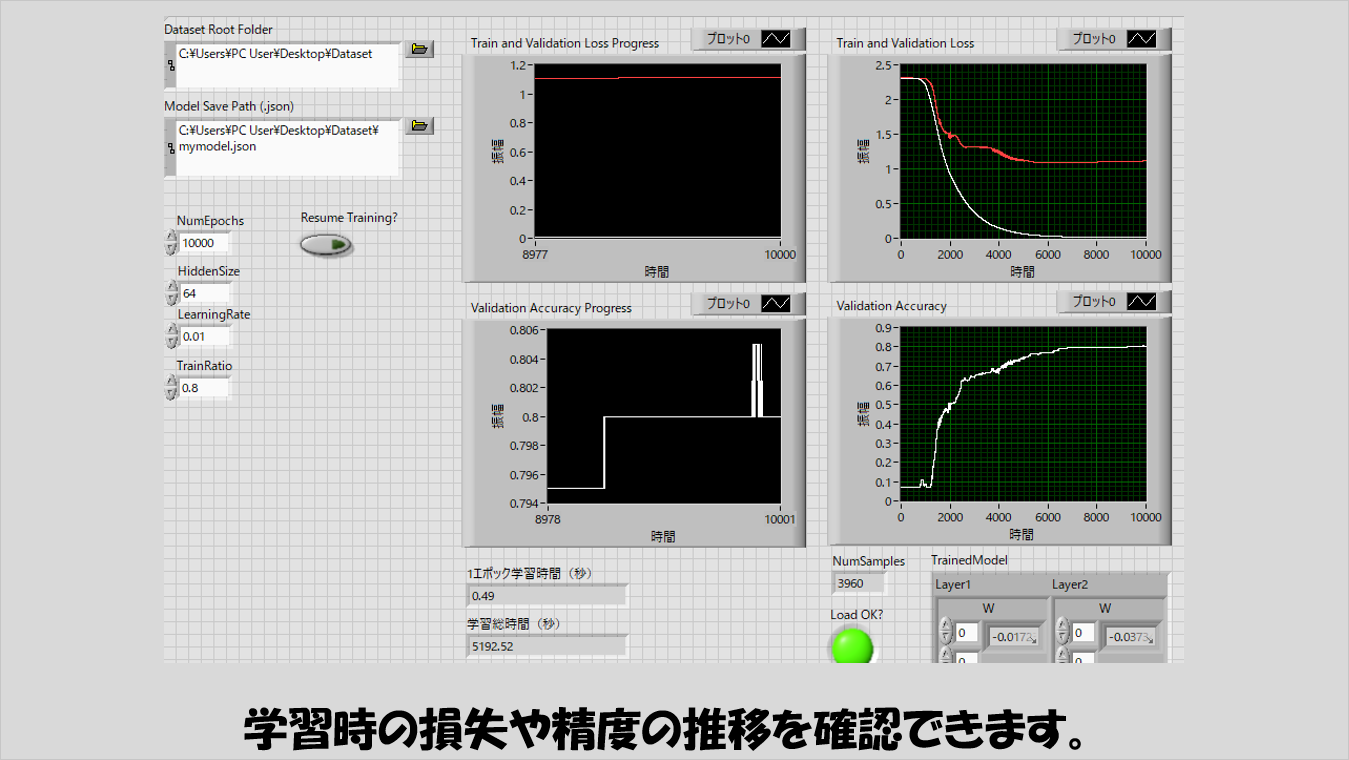
中間層の数や学習率、エポック数もパラメータとして変えられるようにしています。
学習した後の結果、いわゆる「重み」パラメータはjsonファイルに保存しています。
手書き数字を認識するモデルの実態が、こうした数字の羅列でできている、というのは、ディープラーニングの仕組みを全く知らない人から見ると奇妙に思えるかもしれません。
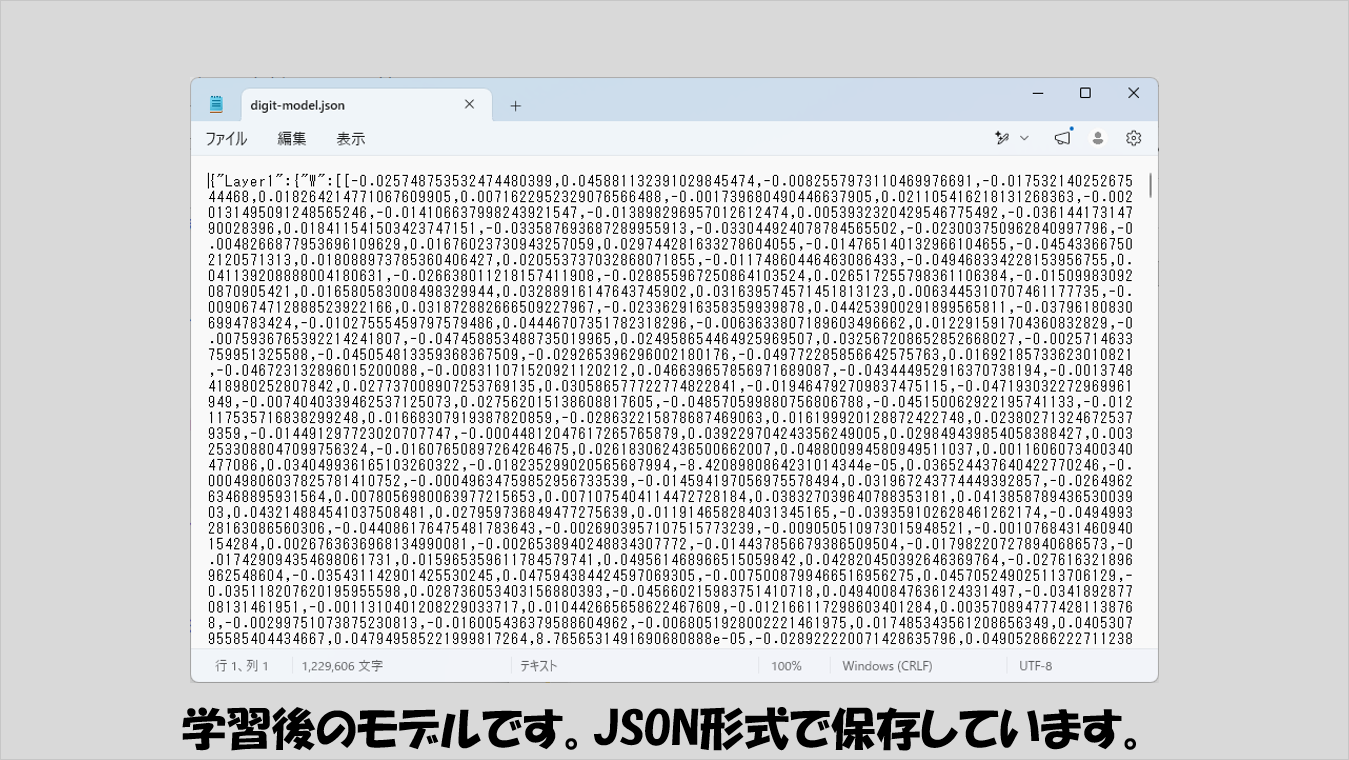
ブロックダイアグラムの大枠
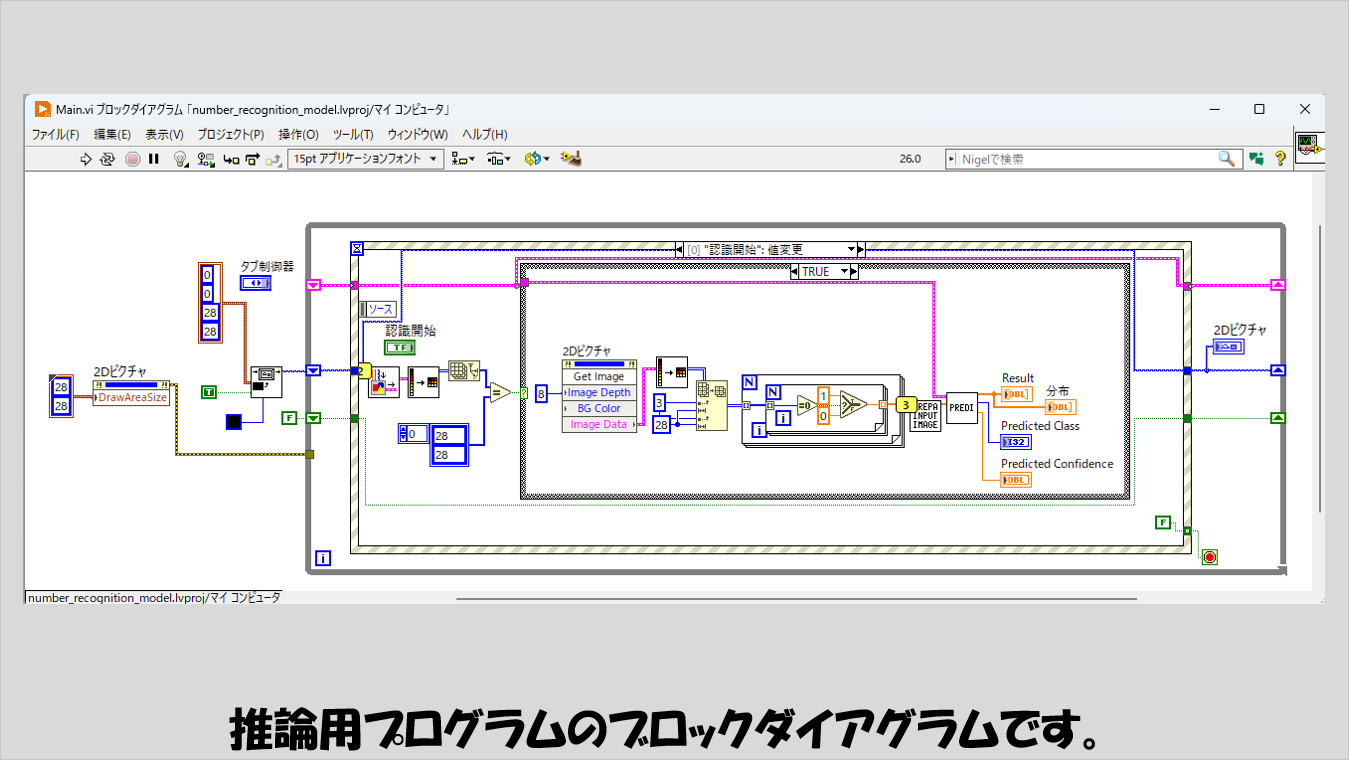
プログラムで使用しているサブVIひとつひとつを紹介することはしませんが、大枠でどのような実装としているかをいくつか紹介していこうと思います。
以下は推論用プログラムのブロックダイアグラムで、イベントベースのプログラムとしています。
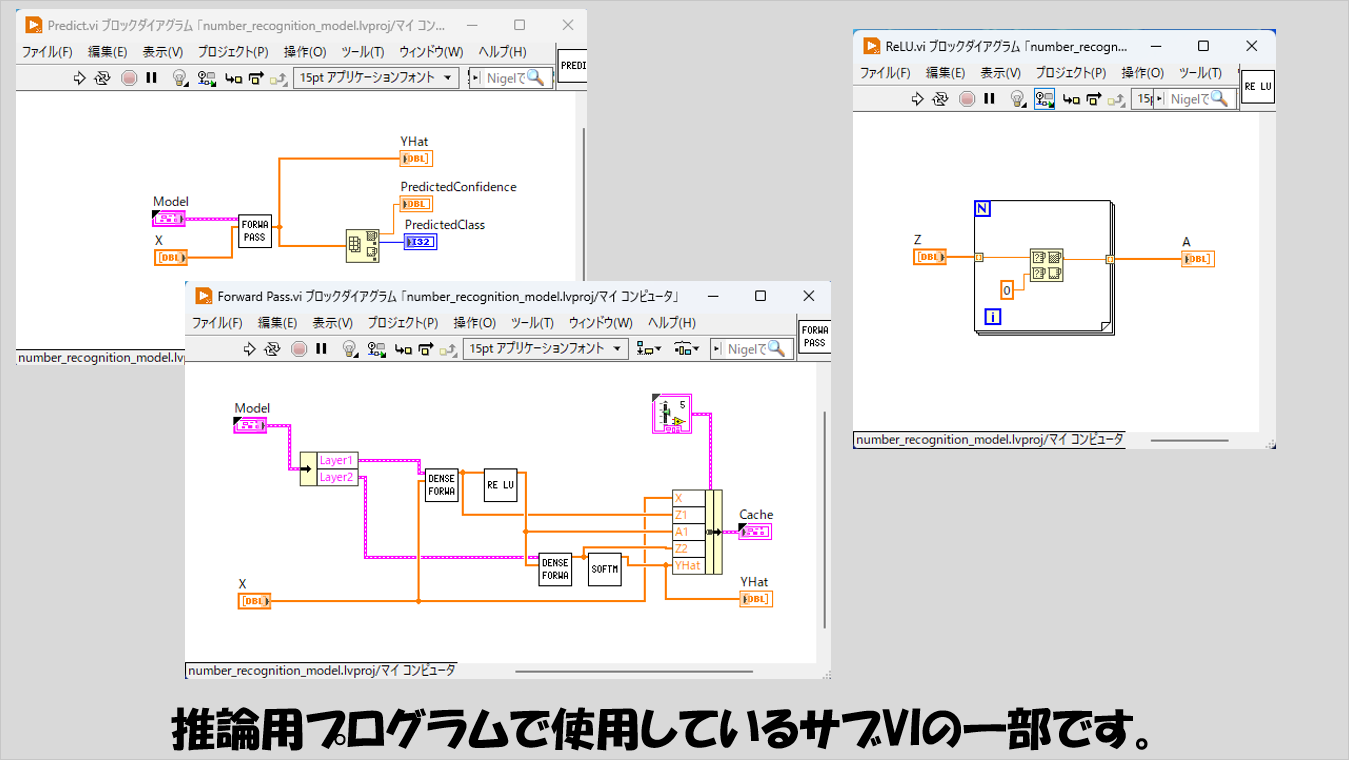
書かれた数字を識別するために、順伝播の処理を行います。
活性化関数としてはReLUを用いました。
学習用プログラムは以下のように用意しました。
これだけ見ても何もわからない、という感じかと思いますが、かなりシンプルに書けていると思います。
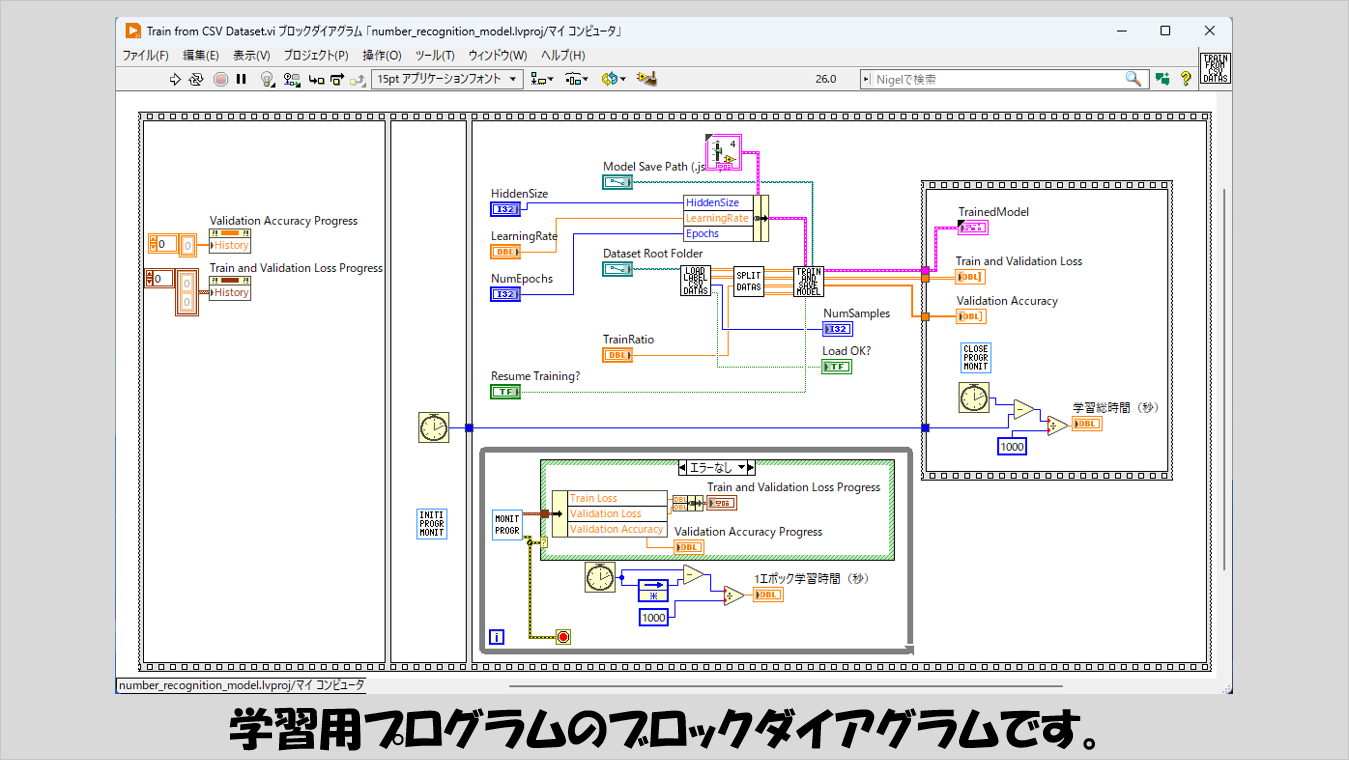
重みパラメータを初期化するかあるいは既存のモデルファイルから読み取るか、といった処理をいれつつ、順伝播、逆伝播を行って学習を進められるようにしています。
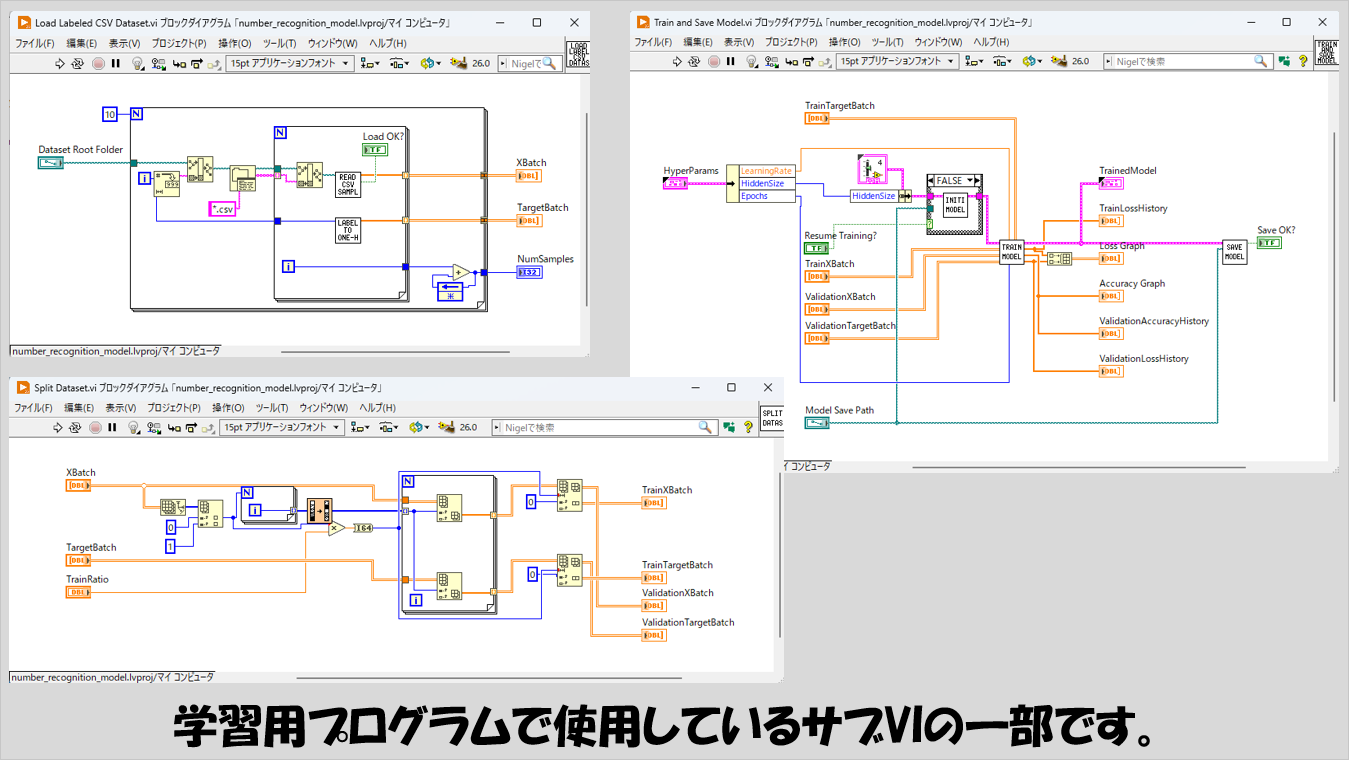
ここではほんの一部のプログラムしか紹介していませんが、ひとつひとつは小さなサブVIであるもののそれらが組み合わさって、ちゃんと手書き数字を認識するモデルが構築できるというのは不思議な感じがします。
どのように進めていったのか
上記のようなプログラムを作りたい、と思ってくれた方ももしかしたらいるかもしれません。
Nigelが使える環境であれば、LabVIEWでどのようにプログラムを組めばいいかをかなり細かく教えてもらうことができます。
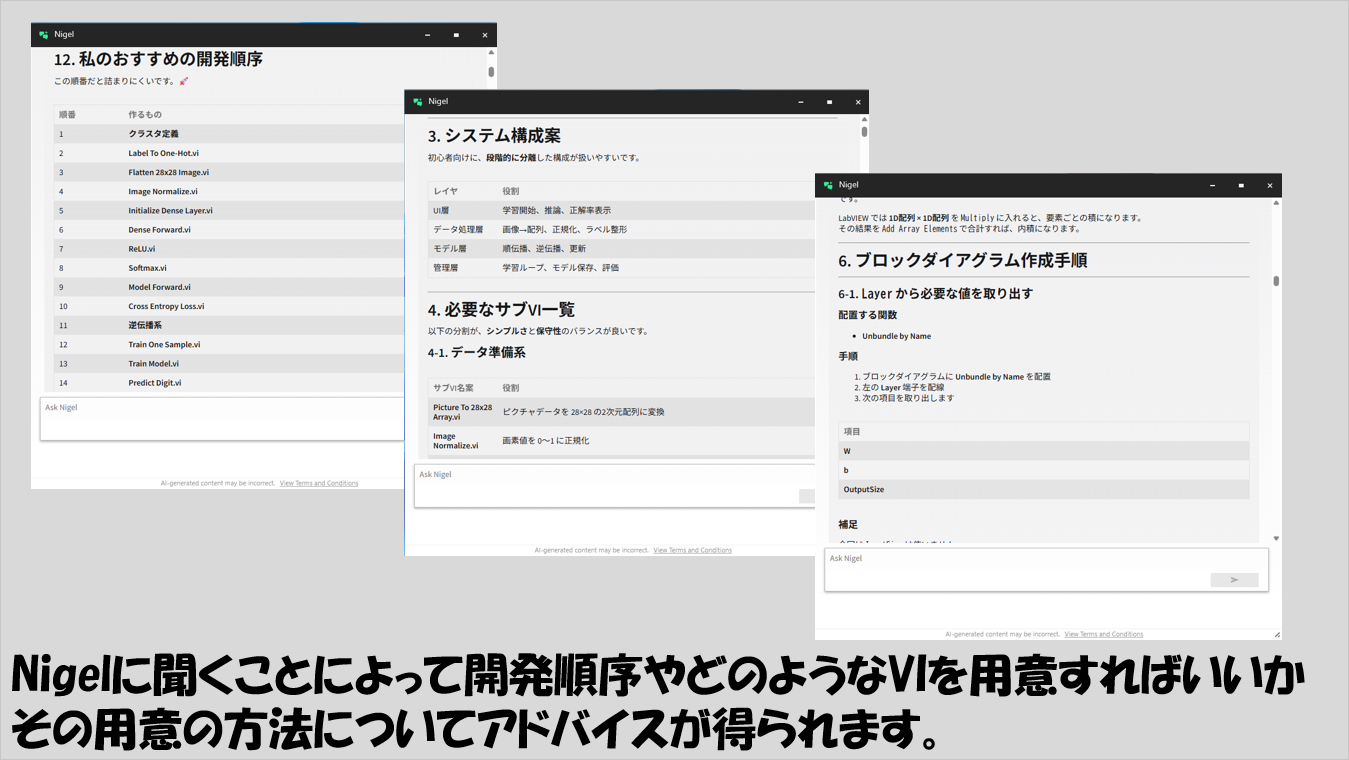
こうしたことは、Nigel以外のAIでもLabVIEWのプログラムの組み方について教えてくれるとは思います。
ただ、LabVIEWを知っているNigelだからこそできるアドバイス、みたいなものもあるので、使えるのであればNigelを使った方がスムーズかと思います。
では私の場合どのようなプロンプトを与えていてどのようにプログラム開発を進めていったのか、については次回の記事で紹介していこうと思います。
本記事では、LabVIEWのみでディープラーニングモデルを作成し実際に手書き数字を認識させるプログラムを作成することを題材に書きました。
そんな事今更やる必要はない、と言われればそれまでですが、自分たちが普段よく使っている技術の根本的な作りを自分で実際に作って実行してみることに面白みを感じてくれる人もいると思うので、そういった方へのモチベーションになればと思います。
ここまで読んでいただきありがとうございました。
コメント